智算通鉴
从设备供应到系统交付:AI基础设施产业链的价值正在向哪里转移?
过去分析AI基础设施产业链,最容易使用的框架是:谁能提供更多GPU,谁就能获得更多商业价值。
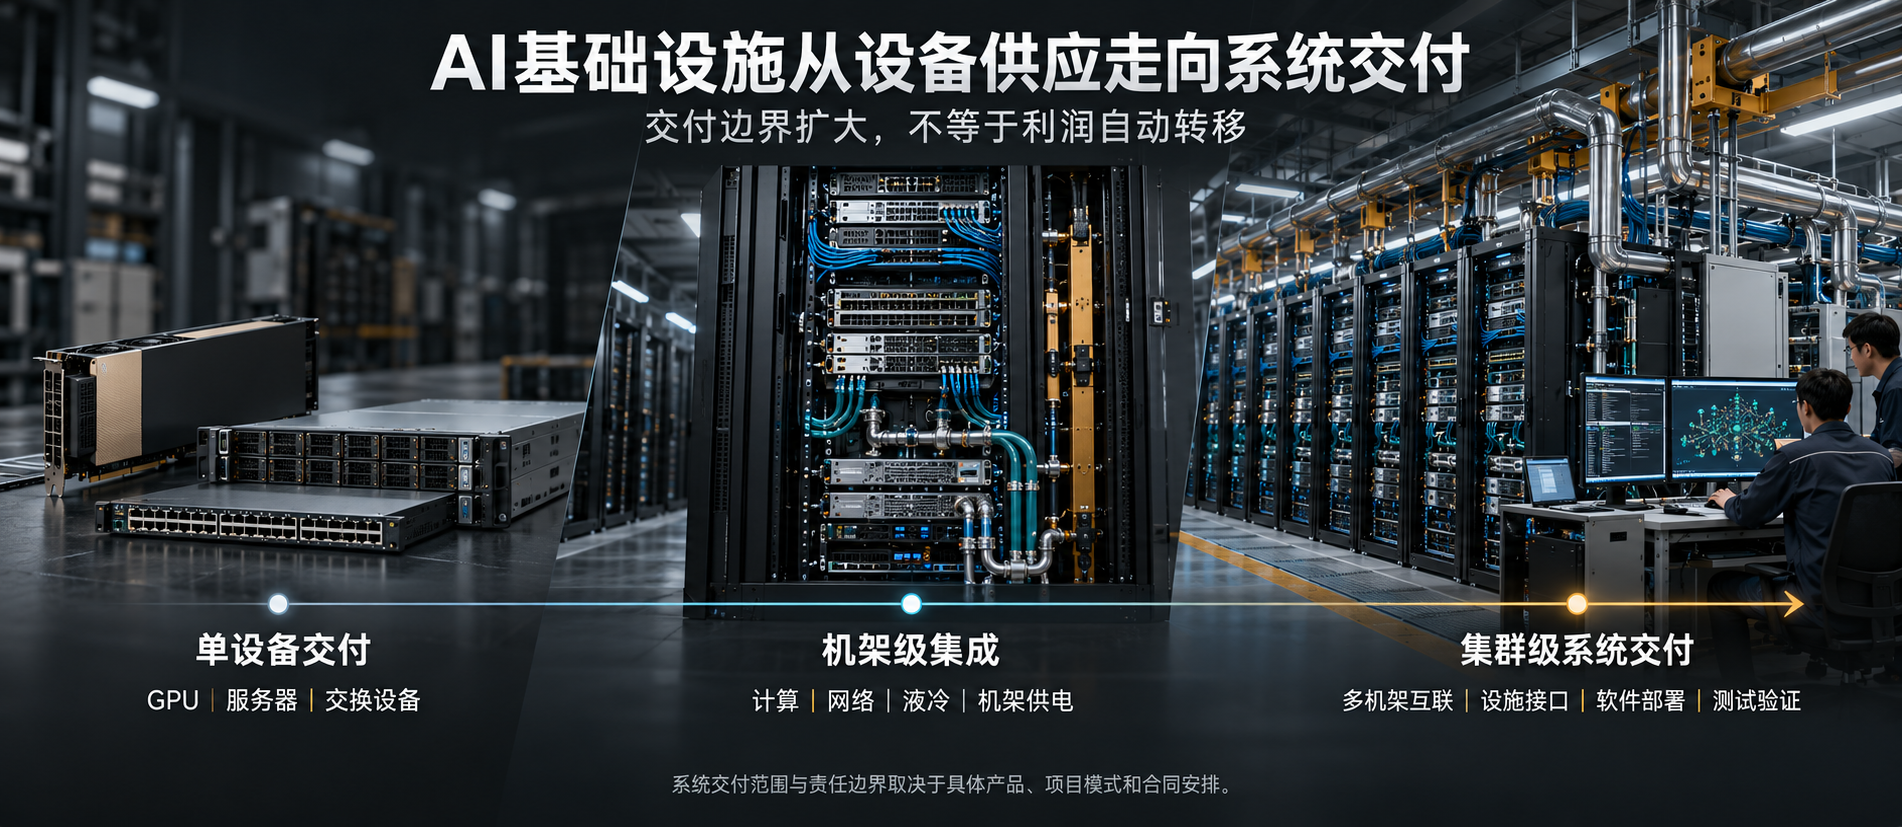
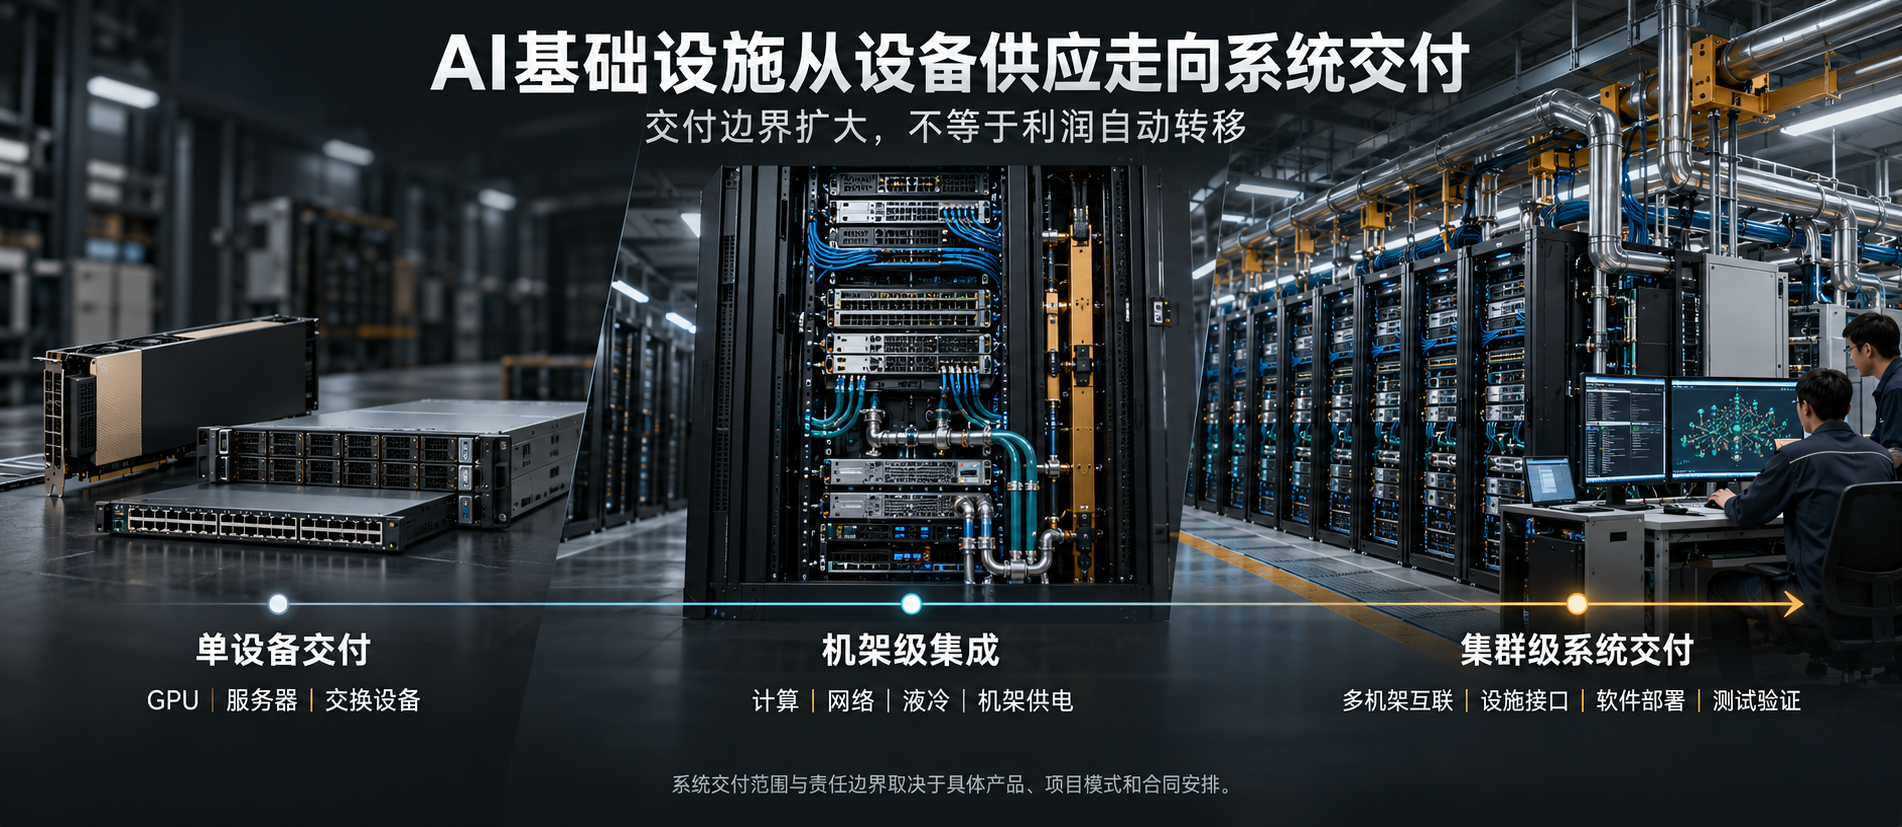
GPU依然是AI系统中价值高度集中的核心部件,但在大型、高密度AI集群中,部分客户的采购与交付对象正在从单一设备扩大到预集成机架和多机架系统。
客户需要的,不只是若干GPU、服务器和交换机,而是一套能够按期安装、稳定运行并通过合同验收的计算系统。
产品边界扩大后,参与企业承担的责任也随之变化:芯片企业开始定义机架和集群架构,服务器厂商需要交付预集成系统,网络与液冷设备要与计算平台共同适配,工程团队则需要解决IT设备与物理设施之间的接口。
这是否意味着利润正在从设备制造转向系统集成和服务?
目前还不能直接下结论。
技术集成责任增加,可以从产品架构和交付方式中观察;利润是否发生转移,则需要订单、收入结构、利润率及合同范围等证据。两者相关,但不能画等号。
AI基础设施的采购单位正在扩大
传统服务器项目可以分别采购处理器、内存、存储、网络和机箱,再由服务器厂商或集成商完成组装。
高密度AI集群更复杂。
大量GPU需要通过高速互联组成计算域,CPU、网卡、交换系统、存储和软件栈必须协同工作;机架功率和发热量上升后,配电、液冷和控制系统也要提前适配。
任何一个关键环节没有达到设计状态,都可能影响GPU利用率和项目投运时间。
在此前GPU、服务器和机架级产品基础上,NVIDIA进一步将Vera Rubin扩展为POD级平台。其官方架构由五类专用机架级系统组成,分别承担GPU计算、CPU计算、低延迟推理、上下文存储和网络连接等任务,并作为一个AI超级计算机协同运行。
AMD Helios也不是单独销售MI455X GPU的概念,而是把GPU、EPYC CPU、Pensando网络、ROCm软件和机架设计组合为开放的rack-scale架构,支持从单机架扩展至多机架集群。
这些产品表明,部分AI基础设施项目的竞争单位正在从:
芯片 → 服务器 → 机架级系统 → 多机架集群
逐步扩展。
这不是说芯片本身不再重要。变化在于,仅有高性能芯片,已经不足以独立完成大型AI集群的价值兑现。
GPU厂商正在扩大架构控制范围
芯片企业首先获得的,不一定是更多工程收入,而是对系统架构更强的影响力。
当GPU厂商同时定义CPU、机架内互联、scale-out网络、存储接口、软件栈和参考架构时,下游企业需要围绕这些架构完成产品适配。
这种控制能力可能扩大单个项目覆盖的产品范围,也可能增强客户对同一平台、软件栈和生态系统的持续依赖。
Vera Rubin POD就是这一趋势的代表。NVIDIA不再把GPU机架作为孤立产品,而是将多类机架、网络、存储和软件组织成一个协同系统。
不过,扩大架构控制范围,不代表GPU厂商已经直接承包整座数据中心。
土地、电网接入、建筑、变配电、设施冷却、消防和现场施工,仍由开发商、公用事业机构、设计团队、设备供应商和工程承包方分工完成。芯片与平台企业扩大的是IT系统的定义范围,并开始向设施接口延伸。
服务器厂商从组装设备走向交付系统
机架级架构扩大后,服务器厂商的工作也不再只是把芯片安装进机箱。
在部分项目中,它们还需要承担机架级硬件设计、网络与电源集成、直接液冷适配、固件与软件验证、工厂预集成、现场部署以及后续技术支持。
HPE与AMD Helios的合作体现了这一变化。
HPE版本Helios基于AMD GPU和CPU,并整合HPE Juniper Networking交换设备、相关软件及直接液冷方案。
2026年9月,HPE宣布获得Vultr价值12亿美元的订单,在美国数据中心部署AMD Helios AI Rack by HPE。这是HPE披露的首笔Helios订单,也是一笔金额明确的机架级系统采购。
这笔订单表明,服务器厂商可以通过整合计算、网络、冷却和部署服务,获得覆盖范围更大的系统订单。
但12亿美元是订单金额,不是HPE从该项目获得的利润。公开材料没有披露其中芯片、网络、服务器制造和服务分别贡献多少收入,也没有披露该订单的成本结构、利润率及付款安排。
因此,它可以证明系统级采购正在落地,不能单独证明利润已经从芯片企业转移到服务器厂商。
网络与液冷开始更早进入系统设计
在大型AI集群中,网络不只是负责把服务器连接起来。
Scale-up互联决定紧密计算域内的GPU能否高效交换数据;scale-out网络则负责连接不同服务器、机架或计算域。存储、管理和前端业务还可能使用不同的网络。
网络企业因此需要更早参与机架和集群设计。
HPE的Helios方案将专用scale-up交换设备和软件纳入整套机架系统。NVIDIA则通过NVLink、InfiniBand和Spectrum-X Ethernet等技术,把GPU、机架和集群互联组织在同一平台体系内。
网络企业能够获得多少商业价值,取决于它是只提供交换芯片,还是同时提供交换设备、网络操作系统、部署调优和长期支持。
液冷也在发生类似变化。
液冷系统可能涉及冷板、机架歧管、软管与连接器、CDU、换热设备、设施侧水系统、控制平台及泄漏监测。OCP关于液冷集成的材料,也把冷板、歧管、CDU、换热器、软管和连接器等组件纳入Technology Cooling System讨论。
这使液冷企业出现两类不同角色。
一类主要提供CDU、换热器或连接器等标准化设备;另一类还参与热管理方案设计、设备选型、设施侧与服务器侧接口、现场调试和长期维护。
后一类企业承担的工作范围更大,但风险也会增加。水质、流量、温度、压力、材料兼容性和泄漏处理,都可能成为其合同责任的一部分。
所以,液冷集成责任扩大,不代表利润一定提高。如果项目接口频繁变化,而新增风险没有反映在合同价格中,更多责任反而可能增加履约成本。
工程交付开始处理更多IT与设施接口
高密度AI机架让IT设备与物理设施之间的边界变得更加紧密。
OCP在Open Data Center for AI计划中,将计算、机架结构、供配电、冷却和遥测接口纳入同一协同框架,推动开放参考设计与接口标准。
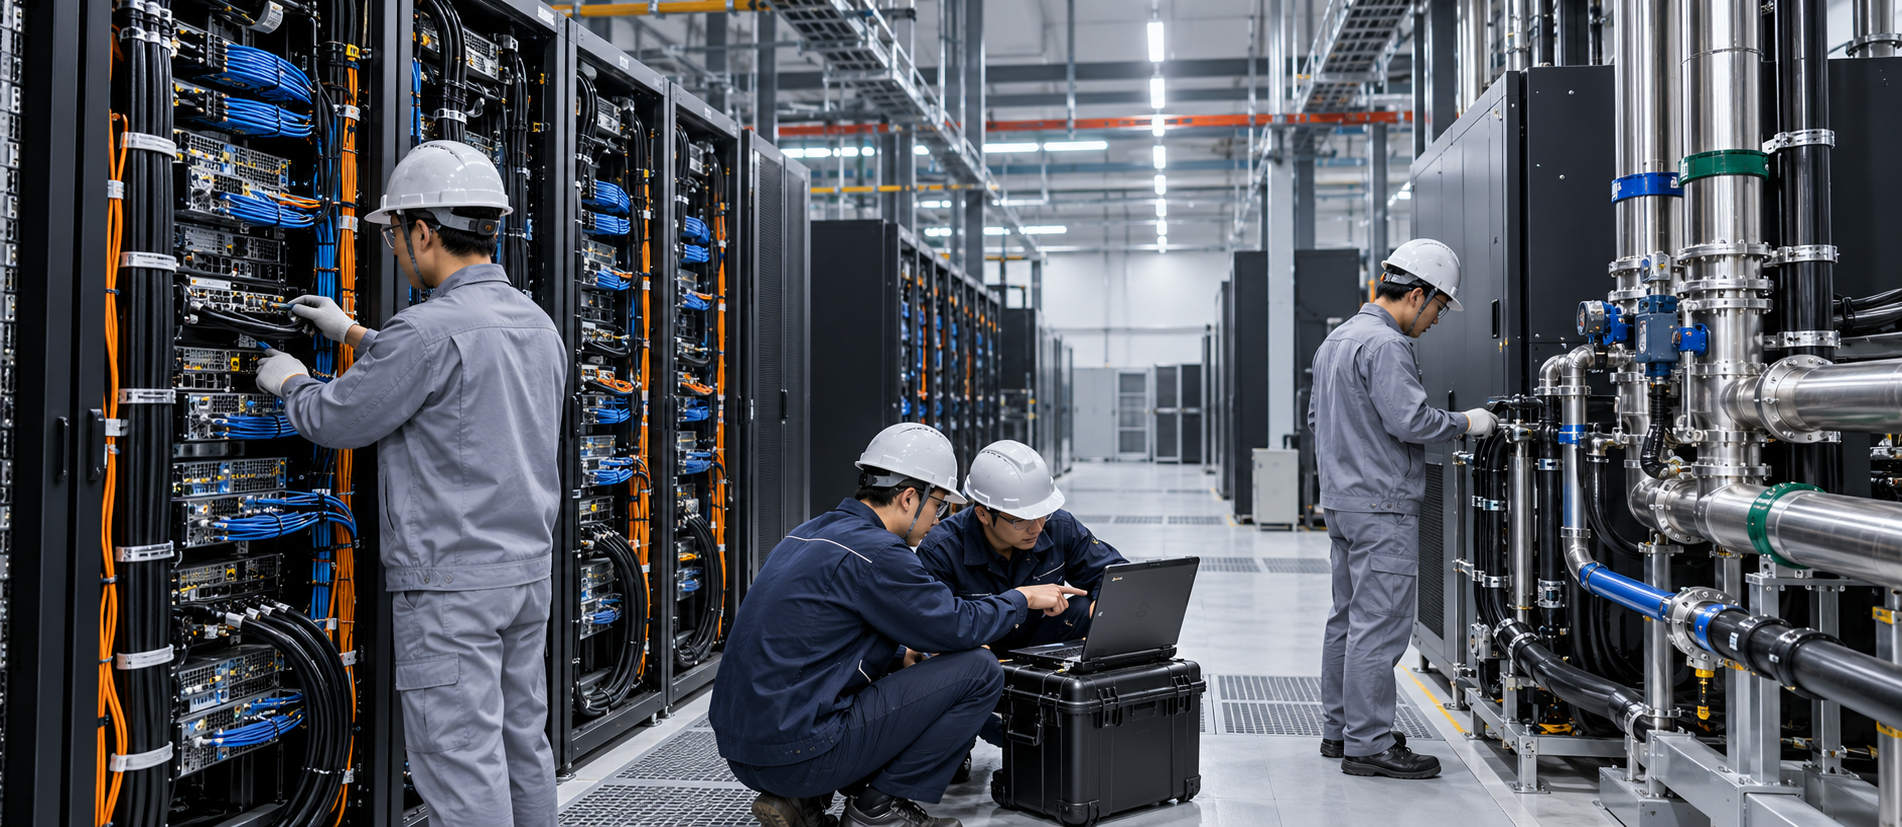
对设计院、机电承包商和工程集成团队而言,这意味着需要更早确认机架功率和冷却参数,协调服务器、母线、CDU和设施水系统,并处理设备重量、运输通道、维护空间及控制系统接口。
工程企业因此可能获得范围更大的合同。
但工程收入规模同样不能直接代表利润质量。在采用固定总价等风险承担较重的合同安排时,工期延误、设计变更和设备接口不确定性,都可能增加承包方成本。
能否通过标准化设计、供应链管理和接口控制减少返工,才会影响新增工程收入最终能否形成利润。
测试验收正在成为系统交付的关键一环
数据中心设施调试通常包括供电、制冷、消防和控制系统;AI项目还需要加强高密度IT设备与设施系统之间的联合验证。
项目可能需要检查:
- 机架达到高负荷时,供配电和液冷系统是否稳定;
- 网络、存储和软件栈是否达到合同约定性能;
- 设备发生故障时,系统能否按照设计切换;
- 监控系统能否准确识别和定位异常;
- 设施容量与可交付的IT容量是否一致。
测试验证本身未必占项目总投资的很大比例,却可能直接影响投运时间和客户验收。
一座数据中心即使完成建筑施工,如果网络、液冷或软件适配没有通过验证,仍可能无法稳定承载客户工作负载。
因此,测试与调试环节的价值,不只在于发现故障,更在于减少“设施已经建成,但计算系统无法按期投入使用”的风险。
这一价值能否形成更大的商业收入,取决于测试工作是否被纳入独立合同、验收指标是否清楚,以及相关机构实际承担什么责任。
售后服务把一次性交付延伸到系统生命周期
机架级系统投入运行后,客户仍需处理固件升级、软件兼容、网络调优、液冷维护、备件更换和故障分析。
AMD在介绍Helios时强调机架级可维护性,希望通过模块化设计降低维护中断。NVIDIA也把系统韧性和持续可用性纳入Vera Rubin平台设计。
这意味着部分商业价值可能从一次性设备销售延伸到软件支持、延长质保、备件服务、驻场运维、集群性能优化和生命周期升级。
长期服务能够延长收入确认周期,并增加持续客户关系的可能性,但仍需结合续约率、服务成本和赔偿责任判断其实际价值。
如果服务依赖大量驻场人员、备件投入或严格的可用性承诺,其收入持续时间虽然更长,成本和履约风险也可能同时上升。
商业价值可能向四类能力延伸
从目前的产品和交付模式看,AI基础设施的商业价值可能向四类能力进一步延伸。
第一类:定义系统架构
掌握芯片、互联、软件或参考架构的企业,可以影响生态伙伴的产品适配方向,并扩大自身技术覆盖范围。
第二类:重复交付机架级系统
这类企业不只是组装服务器,还能完成计算、网络、冷却、固件和软件的预集成,并将项目经验转化为可以重复部署的产品。
第三类:解决IT与设施接口
高密度机架要求供电、冷却、建筑结构和控制系统同步设计。能够跨越传统专业边界的网络、液冷、工程和控制系统企业,可能获得更大的交付范围。
第四类:承担长期服务
软件支持、备件、维护和性能优化,可以把一次性设备销售延伸为持续客户关系。
不过,这四类能力只是更有可能扩大商业价值,并不意味着相关企业已经获得更高利润。最终结果仍取决于竞争强度、议价能力、采购成本、合同条款和交付效率。
判断价值是否真的转移,要看五项证据
判断一家企业是否从系统交付中获得了更大的商业价值,至少需要观察五项证据。
第一,合同范围是否扩大。
企业只提供零部件,还是同时承担系统设计、安装、调试和服务?
第二,单个项目收入是否增加。
机架级产品是否带来更大的订单金额,还是仅将原来分散采购的设备重新打包?
第三,收入结构是否改善。
软件、订阅、维保和长期服务收入占比是否提高?
第四,利润率是否得到验证。
更大的收入是否被设备采购、工程实施、库存、质保和履约成本抵消?
第五,风险如何分配。
如果项目延期、性能不达标或设备需要整改,责任由谁承担?合同是否为新增风险提供合理补偿?
只有这些信息逐步披露后,才能判断价值是停留在架构控制和订单规模层面,还是已经转化为更好的收入质量与利润。
价值没有简单地从上游流向下游
AI基础设施产业链正在发生的,不是价值从GPU厂商简单转移到服务器、液冷或工程企业。
更准确的说法是:
商业价值正在向能够控制关键架构、整合多个系统、缩短交付时间并提供长期服务的能力扩展。
GPU仍是系统中的高价值核心;网络、存储、液冷和供配电的重要性正在提高;服务器厂商和集成商获得了更大的交付范围;工程、测试和售后服务也开始进入更早、更深的项目阶段。
但责任扩大不一定带来利润增长。
有些企业可能通过架构控制和软件形成更强的议价能力;有些企业虽然获得大额系统订单,却同时承担更多采购和履约成本;还有一些工程与服务企业可能增加收入,但也面临延期和性能保证带来的风险。
因此,观察AI基础设施产业链,不能只问“谁参与得更多”,还要继续追问:
谁控制技术标准,谁拿到真实订单,谁承担交付风险,谁能够把一次性项目转化为长期收入。
这些问题的答案,才会决定AI基础设施的商业价值最终流向哪里。