智算通鉴
2026 OCP全球峰会:AMD推出Helion,AI智能体开始拥有专用机架
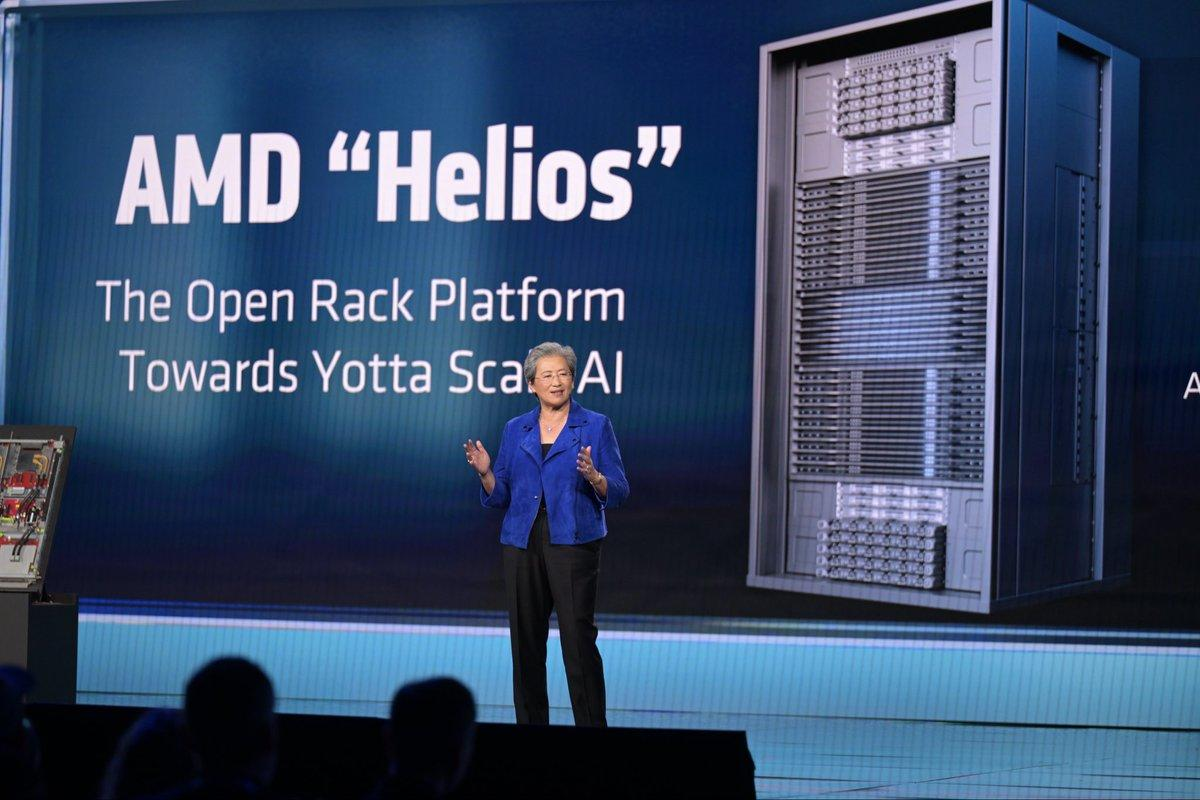
10月12日,AMD在2026年开放计算项目全球峰会(OCP Global Summit)期间,发布了专门面向智能体AI(Agentic AI)工作负载的Helion机架级参考设计。
Helion提供纯CPU和CPU/GPU混合两种配置。根据AMD公布的规格,纯CPU机架最多支持32768个Zen 6 CPU核心,混合机架最多可配置16块Instinct MI350P GPU。
AMD计划将Helion设计规格贡献给开放计算项目(OCP),并与合作伙伴推进产品开发。相关配置计划于2026年11月推出,实际供货和客户部署情况仍待披露。
与主要面向大规模AI训练和推理的Helios不同,Helion针对智能体应用中的任务执行、模型调用和数据处理需求,提供可灵活配置的计算资源。
这意味着,智能体AI开始拥有专门设计的机架级基础设施方案。其核心变化,是CPU与GPU不再必须按照固定比例部署。
智能体AI为什么需要更多CPU资源?
大型AI集群的投资重点长期集中在GPU计算能力、显存带宽和高速互联上,但智能体AI的运行方式与传统模型推理有所不同。
一个智能体完成任务时,可能需要调用大模型、检索文件、查询数据库、执行代码,或与企业业务系统交互。
例如,企业使用AI智能体处理订单时,系统可能先调用模型理解需求,再查询库存、计算价格、访问订单系统,最后生成处理结果。
其中,模型推理通常由GPU等加速器承担,而数据库查询、代码执行、任务编排及部分数据处理工作,主要依赖CPU等通用计算资源。
当大量智能体同时运行时,这些非模型推理任务也可能形成较大的CPU计算需求。
AMD认为,对于部分大型部署,独立扩展CPU计算资源,可能比持续增加GPU服务器中的CPU配置更合适。
这并不意味着所有智能体应用都需要独立CPU机架。实际需求仍取决于任务类型、模型调用频率、并发规模和软件架构。
Helion两种机架配置,最多支持32768个CPU核心
Helion提供两种参考配置,分别满足不同规模和部署方式的需求。
第一种是纯CPU机架。
该方案采用第六代AMD EPYC处理器,单机架最多支持32768个Zen 6 CPU核心,主要承担智能体任务执行、调度和通用计算工作。
模型推理可以通过网络调用独立部署的GPU计算资源。
对于已经建设大型GPU集群的云服务商,这种方式允许CPU与GPU计算资源分别扩展,不必始终采用固定的CPU与GPU配置比例。
第二种是CPU/GPU混合机架。
该方案将EPYC CPU计算节点、Instinct MI350P GPU推理节点,以及数据库、存储等资源组合在同一机架内。
根据AMD公布的规格,混合配置最多支持16块MI350P GPU,分别安装在两台各配备8块GPU的服务器中。
两台GPU服务器独立运行,没有跨服务器的GPU Scale-up互连,因此不能将其理解为一套统一互连的16-GPU训练系统。
Helion还引入集成式Token Router,用于将智能体的模型推理请求分配至不同模型,包括本地部署模型和外部模型服务。
这一设计使混合机架能够根据任务需求调用不同的推理资源,但实际调度效率仍需通过部署测试验证。
此外,AMD公布的Helion参考设计最高网络带宽为102Tbps。
32768个CPU核心、16块GPU和102Tbps网络带宽均为相关参考配置的规格上限,不代表每套机架都同时具备这些参数。
Helion与Helios有什么不同?
AMD此前发布的Helios同样采用机架级设计,但两者面向的计算需求不同。
Helios:面向大规模GPU计算。
根据AMD官方资料,Helios采用72块Instinct MI455X GPU和18颗第六代EPYC处理器,通过高速互连构建统一的机架级GPU计算系统。
其设计重点是支持前沿模型训练和大规模推理,强调GPU计算能力、加速器之间的高速互连,以及整套系统的扩展能力。
Helion:面向智能体任务执行。
Helion提供纯CPU与CPU/GPU混合两种方案,重点支持智能体运行过程中产生的通用计算、任务编排、数据处理和模型调用需求。
两种架构的主要区别在于:
计算资源配置:Helios采用GPU密集型架构;Helion允许独立扩展CPU计算资源,或将CPU与GPU推理资源组合部署。
GPU配置:Helios采用72块MI455X GPU;Helion混合配置最多支持16块MI350P GPU。
应用方向:Helios主要面向大规模AI训练与推理;Helion主要面向智能体任务执行及相关模型调用。
产品阶段:Helios已发布并推进客户部署;Helion目前处于参考设计已发布、合作伙伴推进产品开发的阶段。
两种架构并非相互替代。
大型云服务商可以通过Helios等GPU平台承担模型训练和推理,同时使用独立CPU计算资源运行智能体执行环境。
企业客户则可能选择Helion混合机架,将部分GPU推理资源与业务处理系统集中部署。
不过,AMD尚未公布足以证明Helion在实际智能体计算任务中具有明确性能或成本优势的完整第三方测试数据。
开放机架设计,能否走向实际部署?
Helion采用多项OCP开放硬件规范,包括Open Rack v3机架与母排、DC-MHS主机处理器模块、DC-SCM管理与安全模块,以及OCP NIC 3.0网络接口,并提供风冷和液冷配置选择。
这些规范有助于服务器制造商、网络设备供应商和数据中心运营商围绕共同的硬件接口开发产品,也有利于提前规划机架供电、冷却和维护条件。
不过,采用开放规范不代表不同厂商的设备可以直接混用,实际部署仍需完成兼容性测试和系统调试。
AMD公布的Helion合作伙伴包括戴尔、鸿海、HPE、联想、QCT、超微电脑和纬颖等服务器及系统制造企业,并获得思科等技术合作伙伴支持。
合作伙伴参与有助于推进参考设计产品化,但不能直接视为已经获得商业采购订单。
截至2026年10月13日,AMD尚未公布Helion的具体客户订单规模、实际部署数量或大规模运行结果。
接下来需要关注的是,合作伙伴能否按计划推出产品,以及实际部署能否改善智能体并发处理能力、CPU与GPU计算资源利用率、系统功耗和总体拥有成本。
Helion的意义并不是削弱GPU的重要性,而是让智能体执行所需的CPU计算资源成为可以独立规划和扩展的基础设施。
随着AI应用从模型推理走向多步骤任务执行,数据中心需要根据实际任务配置CPU、GPU、内存、网络和存储资源。
Helion提供了一种专门面向智能体AI的机架级设计方案。其商业价值仍需通过产品交付、客户部署和实际运行数据验证。