智算通鉴
6.7万亿美元数据中心投资预测:GPU之外的钱花在哪里?
过去两年,AI基础设施最受关注的几乎都是GPU。
但GPU真正装进数据中心之后,事情才刚刚开始。
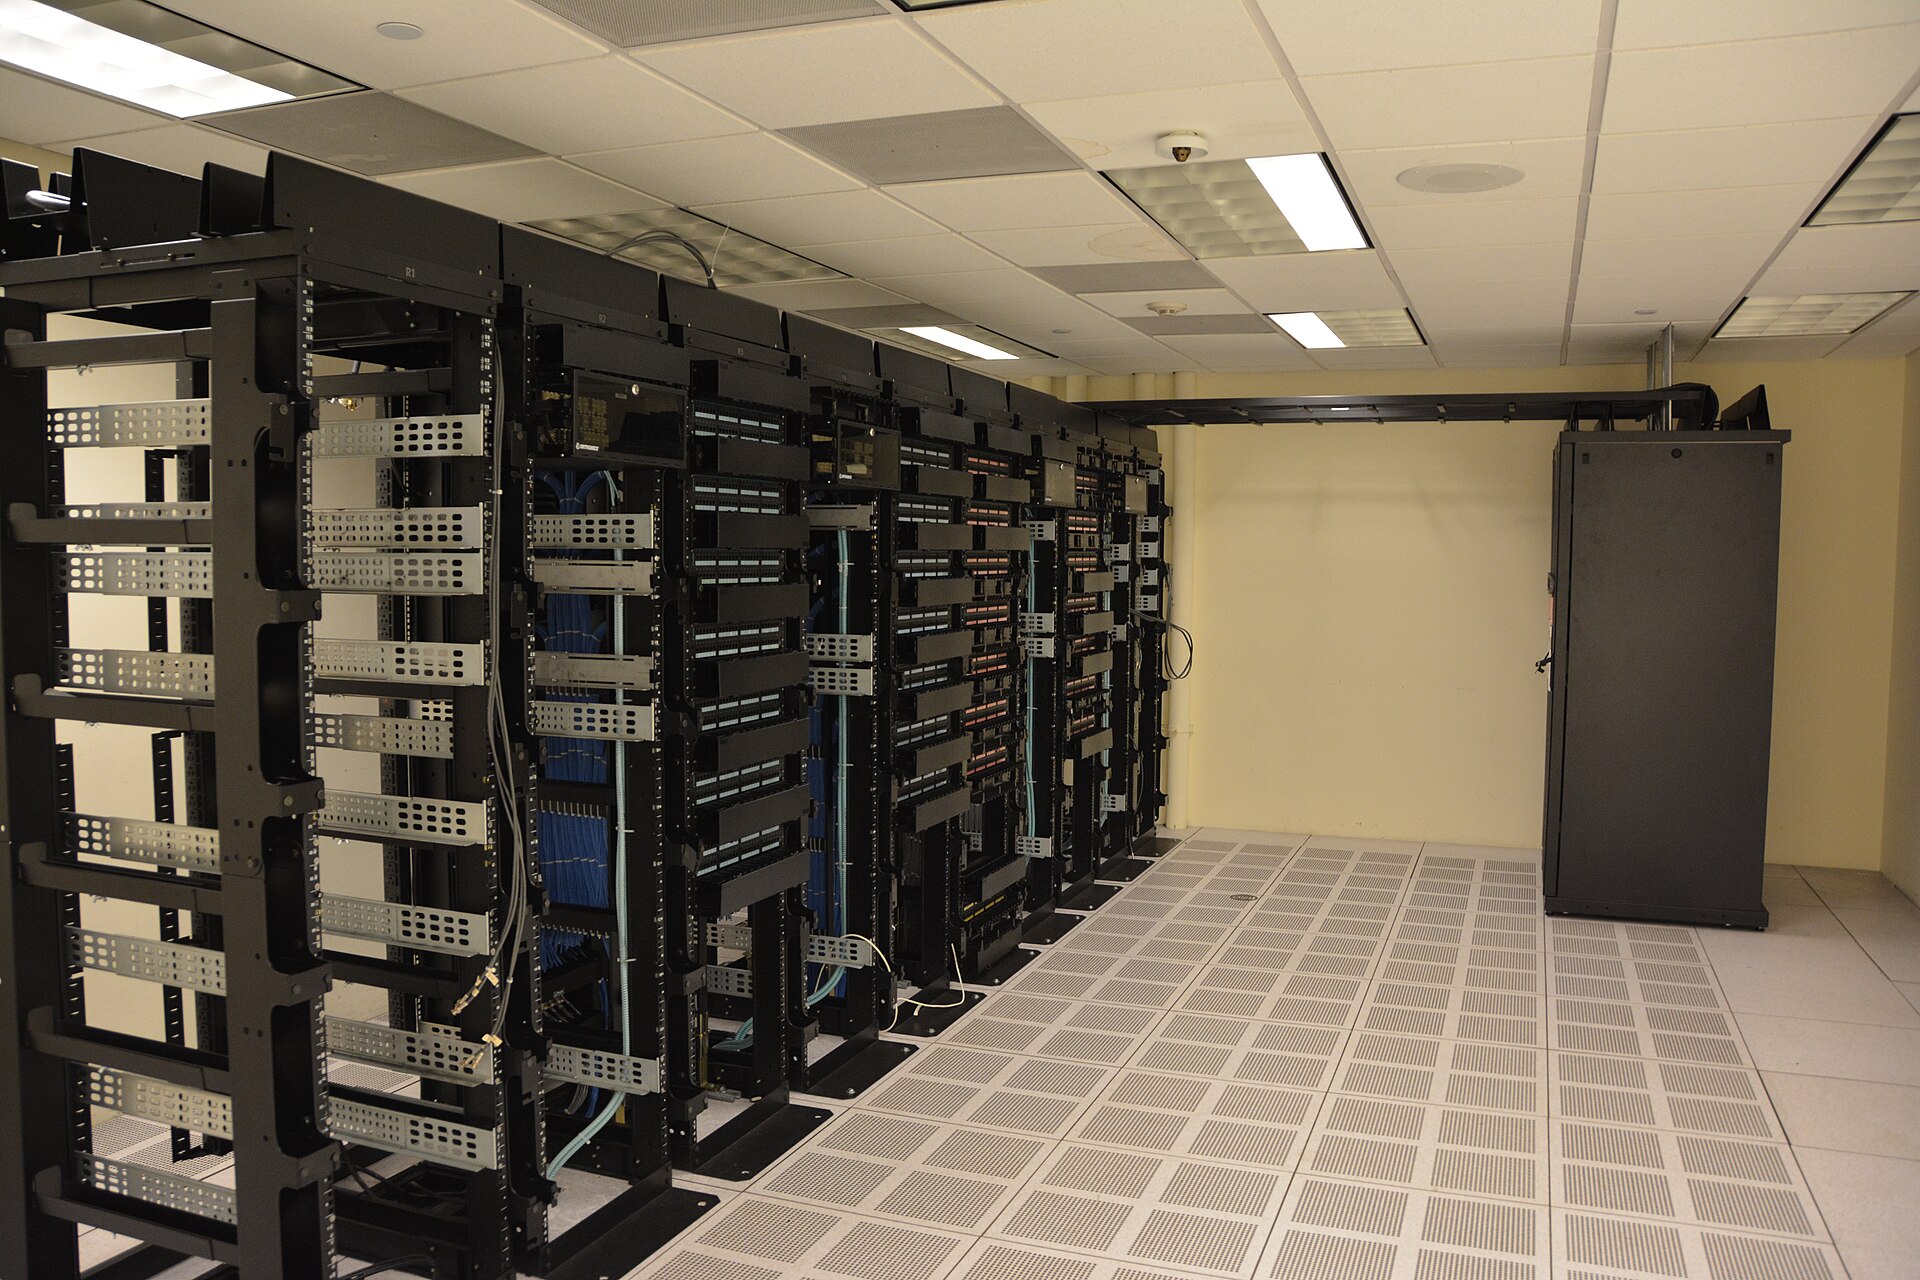
它需要电,需要变压器和供配电设备,需要解决高密度机柜的散热。项目规模到了数百MW甚至GW级,能不能按时获得足够的电力,本身就会影响建设进度。
这也是为什么,最近AI数据中心的订单开始越来越多地出现在一些过去并不属于AI核心叙事的行业里。
McKinsey在2025年研究中预计,到2030年,为满足全球计算需求,数据中心可能需要约6.7万亿美元资本投入。其中约5.2万亿美元与AI相关,另外约1.5万亿美元对应传统IT负载。
约6.7万亿美元是研究情景预测,不是已经发生的资本开支。
比这个数字更值得看的是:钱会花在哪里。
GPU拿走最大一块,但远不是全部
在McKinsey预计的5.2万亿美元AI相关数据中心资本支出中,有一组数字很值得关注:
约7200亿美元可能用于供电和冷却设备。
其中,电力设备约5000亿美元,冷却设备约2200亿美元。
换句话说,当市场还在计算未来需要多少GPU时,仅仅为了让这些计算设备获得稳定供电并把产生的热量带走,就可能形成数千亿美元级别的基础设施投入。
其中最先遇到的问题,就是电。
9月1日,路透社在一篇关于AI数据中心供应链的报道中提到,韩国HD Hyundai Electric、中国金盘科技、台达电子等电力和基础设施设备企业,正在受益于数据中心需求增长。
原因并不复杂。
大型数据中心从电网取得高压电力后,要经过变压、配电,再送到最终的IT设备。GPU越多、机柜功率越高,背后的供配电系统也要跟着扩容。
所以现在看AI数据中心,变压器、开关设备、UPS这些过去并不处在AI产业聚光灯下的设备,越来越难绕开。
GPU可以买,电却不是接上线就有。
当AI数据中心进入数百MW级建设,芯片之外的物理基础设施开始成为项目能否落地的重要约束。
电送进来了,还要把热带出去
另一个被GPU改变的,是冷却。
传统数据中心长期以风冷为主。但在高密度AI机柜场景下,散热压力明显增加,液冷的重要性也随之上升。
大型基础设施厂商已经开始补这块能力。
Vertiv此前收购液冷企业CoolTera;Schneider Electric也通过收购Motivair加强液冷业务。
两家公司都把液冷能力纳入了数据中心基础设施布局。背后的技术背景很明确:AI和加速计算正在推高高密度数据中心的散热需求。
因为对AI数据中心来说,问题早已不是简单地“多放几台服务器”。
一台GPU服务器能不能运行,取决于芯片。
成千上万台GPU能不能长期稳定运行,考验的则是整个数据中心的供电和散热系统。
这也是为什么,在McKinsey的预测中,仅冷却设备到2030年的累计资本需求就可能达到约2200亿美元。
液冷是不是最终唯一的技术路线,现在还不能这么下结论。
但高密度AI计算正在提高冷却系统的重要性,这个方向已经相当清楚。
再往前一步,问题开始延伸到电网之外
9月2日,Vertiv又宣布了一项新的资本动作:达成收购UtilityInnovation Group(UIG)的协议。
交易基础现金对价约14.5亿美元,另外还有最高约11.5亿美元、与未来业绩目标挂钩的额外支付。
UIG做的事情和液冷不同。
它的能力包括微电网控制、现场发电和储能协调、专用开关设备,以及数据中心表后电力架构设计。
为什么一家数据中心基础设施公司会把业务继续往这里延伸?
Vertiv给出的战略逻辑很直接:通过并网或独立于电网的电力架构,帮助数据中心缩短获得可用电力的时间。
这里碰到的是AI数据中心一个越来越现实的约束。
数据中心可以快速规划,GPU也可以持续采购,但电网扩容、变电站建设和输电设施都有自己的建设周期。
两者的速度未必一致。
于是,一些大型项目开始研究更复杂的供电组合:
电网之外,再叠加现场能源、储能和微电网。
这和我们此前持续关注的“算电协同”已经开始接上了。
一边是算力基础设施不断扩大,另一边是电力基础设施必须跟上。过去更多各自规划的两套系统,现在越来越频繁地出现在同一个项目方案里。
5000亿美元电力设备,会花在哪些地方?
McKinsey预测,到2030年,AI数据中心相关电力设备累计资本需求可能达到约5000亿美元。
这笔钱并不只是数据中心机房里的UPS。
从电网到服务器之间,还有一整套基础设施:
变压器、开关设备、备用电源、电力管理系统、配电设备,以及与现场能源和储能相关的设施。
如果继续往数据中心之外看,问题还会延伸到输电和发电。
一个数百MW级的数据中心,本身已经是大型电力负荷。如果一个区域同时规划多个大型AI数据中心,需要考虑的就不只是机房内部有没有足够的变压器,还包括当地有没有足够的电力容量,以及电网能不能及时完成接入和扩容。
这也是为什么,过去一年AI数据中心的讨论里,“time to power”出现得越来越频繁。
对于一个大型项目来说,拿到GPU和拿到电,是两张不同的时间表。
前者属于科技供应链。
后者越来越像基础设施问题。
AI正在把一批传统工业公司拉进自己的供应链
过去谈AI产业链,最容易想到模型公司、芯片公司和服务器厂商。
现在这张名单正在变长。
变压器、UPS、开关设备、液冷、储能、微电网、电网设备、工程建设……这些原本属于电力和工业基础设施的行业,正在和AI数据中心产生越来越直接的联系。
这也是McKinsey“接近7万亿美元”这个数字真正值得看的地方。
不是因为7万亿美元本身足够大。
而是它提醒我们,AI的资本开支已经不能只按照半导体产业链来理解。
模型运行在服务器里,服务器放在数据中心里,数据中心最终还要落到土地、电力、冷却和电网上。
这些都是物理约束。
而物理基础设施的扩张速度,往往和算力需求不是同一套节奏。
所以接下来观察AI基础设施,与其只问“还需要多少GPU”,不如同时多看几个问题:
当地还有多少可用电力容量?
变压器和供配电设备交付要多久?
高密度机柜采用什么冷却方案?
电网接入能不能跟上数据中心建设进度?
如果电网接入周期过长,有没有其他供电方案?
这些问题最终指向的是同一件事:
AI算力继续扩张,需要补的不只是GPU,还有GPU背后的整套物理基础设施。
7万亿美元最终会不会全部投入,现在没人能够确定。
但AI数据中心带来的新增需求,已经不只停留在芯片和服务器。
供电、冷却,以及更上游的电力基础设施,正在进入同一轮AI基础设施扩张周期。