智算通鉴
Anthropic为何考虑直接租赁数据中心?
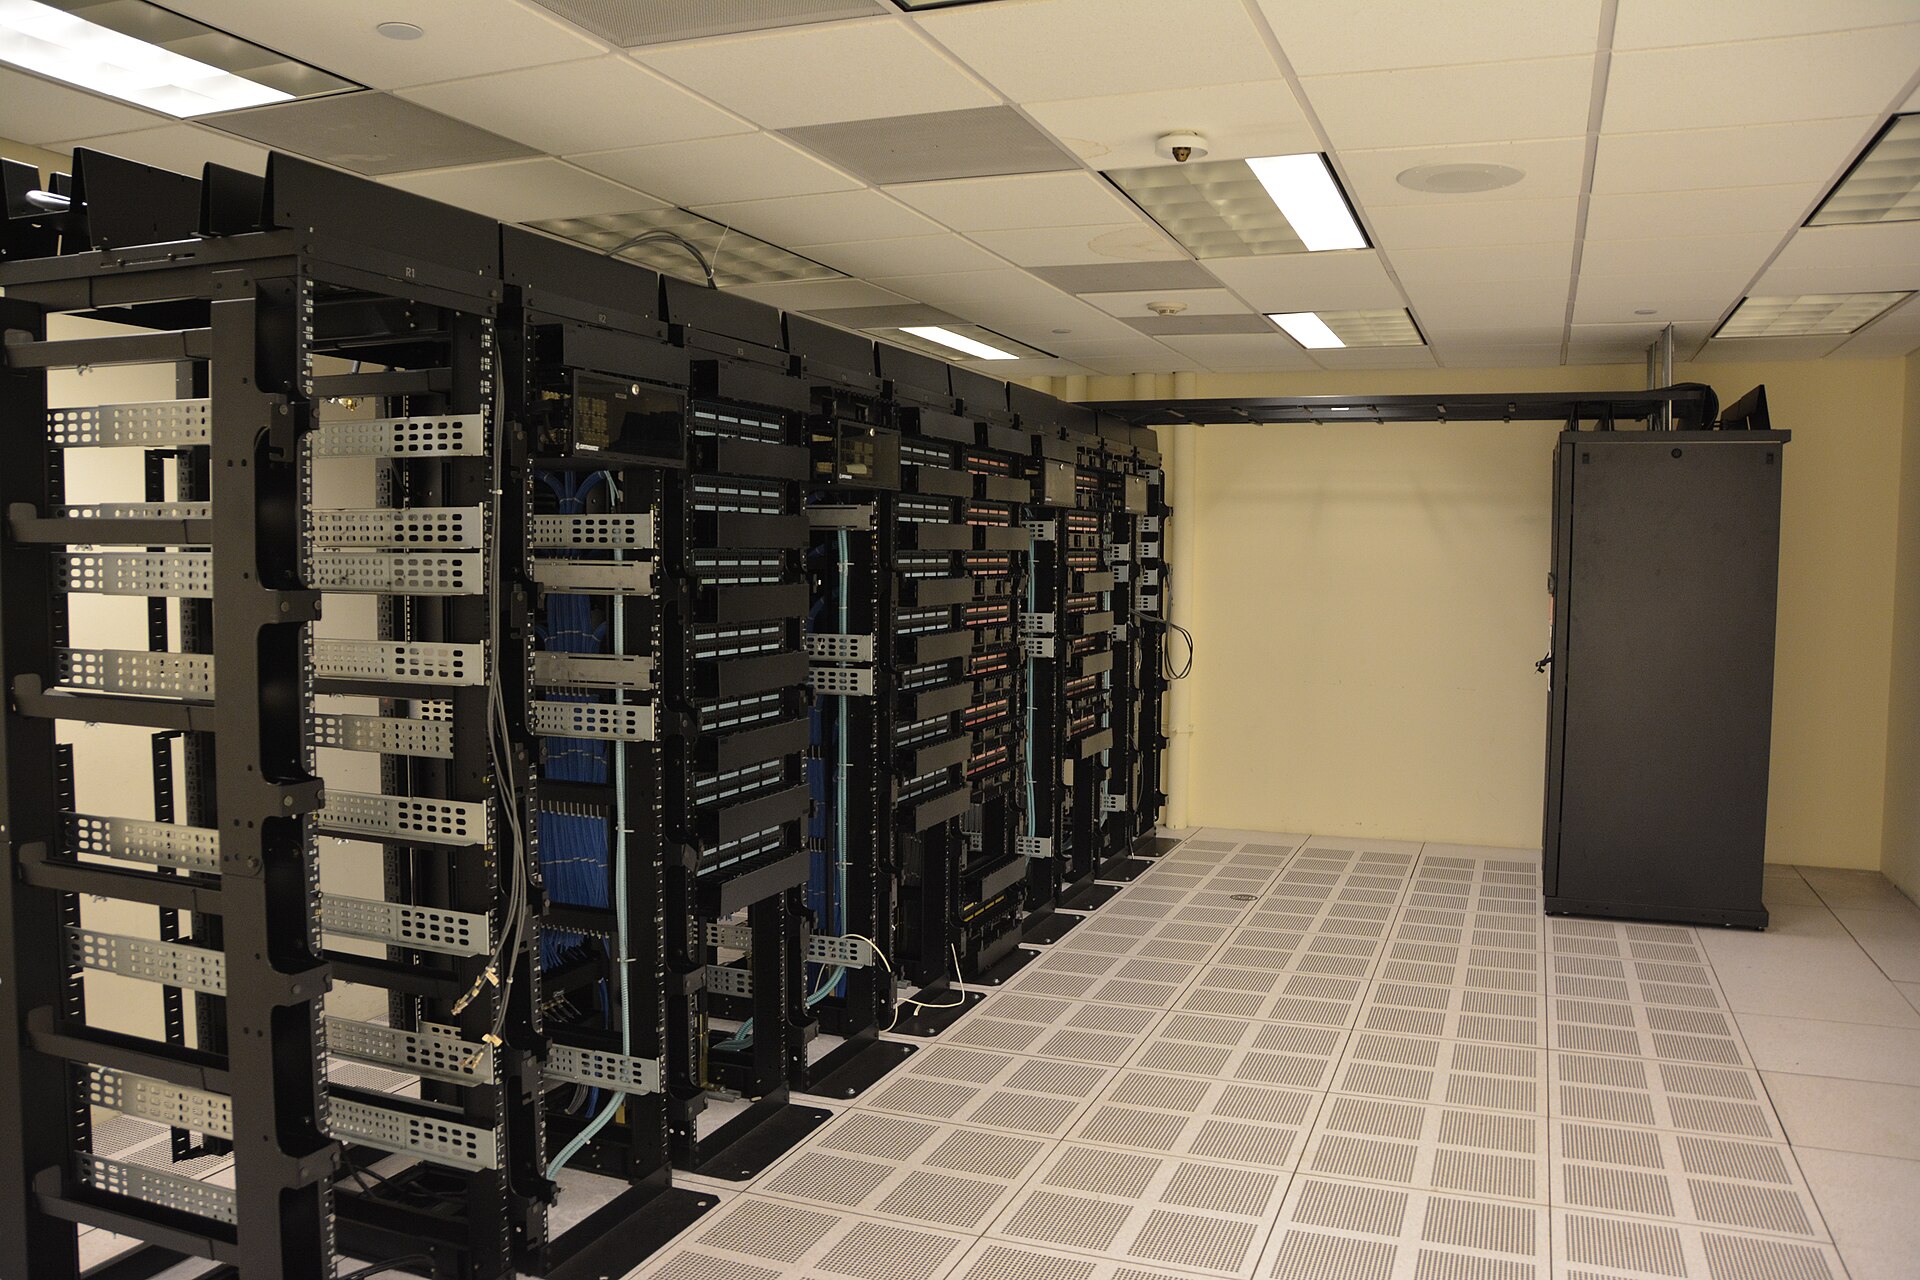
Anthropic正在考虑一种比购买云算力更直接的方式来获得计算资源:直接租数据中心。
据The Information报道,Anthropic正在与Stream Data Centers进行早期谈判,讨论直接租赁最高约1GW的计算容量,并可能成为相关数据中心的直接租户。
目前谈判仍处于早期阶段,不能视为已经签署的正式租约,1GW也不是已经投入运行的计算容量。
但这件事值得关注。
过去几年,Anthropic主要通过AWS、Google等合作伙伴获得大规模计算资源。现在,如果这笔交易最终推进,它与底层数据中心之间的关系将发生一个明显变化:从购买计算资源,进一步参与到物理容量本身的安排。
对于一家核心产品是Claude的AI模型公司来说,为什么要走到这一步?
Anthropic的算力需求已经进入GW级
先看Anthropic今年公布的几笔基础设施合作。
4月,Anthropic宣布进一步扩大与Amazon的合作,未来十年将向AWS相关技术投入超过1000亿美元,获得最高5GW新增计算容量,用于训练和运行Claude。
其中,接近1GW的新容量计划在2026年底前上线。
AWS目前仍是Anthropic的主要云服务商和训练合作伙伴。
但Anthropic并没有把计算资源押在单一平台上。
它还与Google和Broadcom达成了5GW下一代TPU算力合作,相关容量计划从2027年开始陆续上线。
5月,Anthropic又宣布与SpaceX合作,使用Colossus 1数据中心的全部计算容量,获得超过300MW新增容量和超过22万块NVIDIA GPU。
这也让Anthropic形成了一套比较少见的多硬件体系:AWS Trainium、Google TPU和NVIDIA GPU都在使用。
不过,这里的数字不能直接相加。
这些合作签署时间、交付周期、基础设施模式都不同。“签约容量”“计划容量”“正在上线容量”和“已经投入运行容量”也不是一回事。
所以不能把5GW、5GW和300MW简单相加,然后得出“Anthropic已经拥有超过10GW数据中心”的结论。
真正能够确认的是:
Anthropic已经开始按照GW级规模规划自己的计算资源。
有了AWS和Google,为什么还要直接租数据中心?
这才是这次新闻真正有意思的地方。
Anthropic已经可以通过AWS获得Trainium,通过Google获得TPU,也可以使用NVIDIA GPU。
为什么还要考虑自己成为数据中心的直接租户?
Anthropic目前没有公开解释这次潜在交易的完整商业逻辑。
但The Information的报道提到了一个重要方向:Anthropic希望获得对计算基础设施更直接的控制,直接租赁也存在降低部分成本的可能。
放到AI基础设施的实际交付链条里,这个逻辑并不难理解。
当一家公司的计算需求达到GW级,问题已经不只是“能不能买到芯片”。
芯片什么时候交付,服务器什么时候安装,数据中心什么时候建成,电力什么时候接入,最终都会影响同一个结果:
这些算力什么时候真正能用。
对于模型公司来说,合同里写着5GW,并不等于今天就有5GW计算资源可以调用。
这也是为什么“容量”和“交付”必须分开看。
需求规模越来越大以后,谁来协调这些基础设施、谁能控制部署节奏、谁能确保容量按期上线,都会变得更加重要。
直接租赁数据中心,可以让模型公司更靠近这一层。
直接租数据中心,不等于自己建数据中心
这里也需要把边界说清楚。
如果Anthropic最终与Stream Data Centers达成租赁协议,并不意味着Anthropic自己变成了数据中心开发商。
数据中心仍然需要开发商建设和运营。
Anthropic作为租户,更直接参与的是容量使用以及内部计算基础设施的部署。
服务器、AI芯片、机架、网络等设备仍然需要进入这些设施,最终组成真正能够训练和运行Claude的计算集群。
这会带来新的问题。
长期租多少容量?
硬件由谁部署?
不同芯片如何安排?
如果AI硬件快速迭代,今天签下的长期容量几年后是否仍然适合下一代计算系统?
如果需求增长低于预期,又会不会出现容量利用不足?
因此,直接租赁带来的不只是更多控制,也包括更长期的合同承诺和更多基础设施协调责任。
对于计算需求足够大的模型公司,这笔账才有重新计算的必要。
Anthropic没有离开云厂商
直接租数据中心很容易被解读成另一种故事:
AI模型公司准备绕开云厂商。
至少从Anthropic目前公开的基础设施布局看,这个结论并不成立。
今年4月,Anthropic刚刚把与Amazon的计算合作扩大到最高5GW;与Google和Broadcom的下一代TPU合作也在推进。
AWS仍然是Anthropic的主要云服务商和训练合作伙伴。
与此同时,Anthropic还在使用NVIDIA GPU。
因此,更准确的变化不是“离开云”,而是算力来源变得越来越多元。
一部分计算资源来自大型云厂商,一部分来自其他基础设施合作伙伴,未来还可能有一部分来自Anthropic直接租赁的数据中心。
对于GW级需求方来说,这些方式并不一定互相替代。
它们更可能同时存在。
模型公司开始更关心“算力怎么交付”
Anthropic这次潜在的1GW租赁,真正值得继续观察的其实不是1GW这个数字本身。
而是模型公司与数据中心之间的关系正在发生变化。
当计算需求还没有这么大时,模型公司可以主要通过云平台解决基础设施问题。
但进入GW级以后,电力、数据中心建设、服务器部署和芯片交付都会影响模型最终能够获得多少真实算力。
这时候,“买算力”和“参与算力基础设施”之间的边界自然会变得模糊。
Anthropic最终是否会签下Stream Data Centers这笔最高约1GW的租赁,现在还没有答案。
但它提出了一个值得长期跟踪的问题:
当头部模型公司的计算需求进入GW级,它们还会把多少基础设施问题完全交给云厂商?
模型能力仍然是AI公司的核心竞争力。
但对于Anthropic这样的公司来说,另一个越来越现实的问题是:
需要的算力,能不能按时交付。
资料来源:Anthropic官方公告、The Information等公开资料。
本文基于公开资料进行产业研究与信息分析,不构成任何投资建议。