公众号原发布时间:2026-09-20
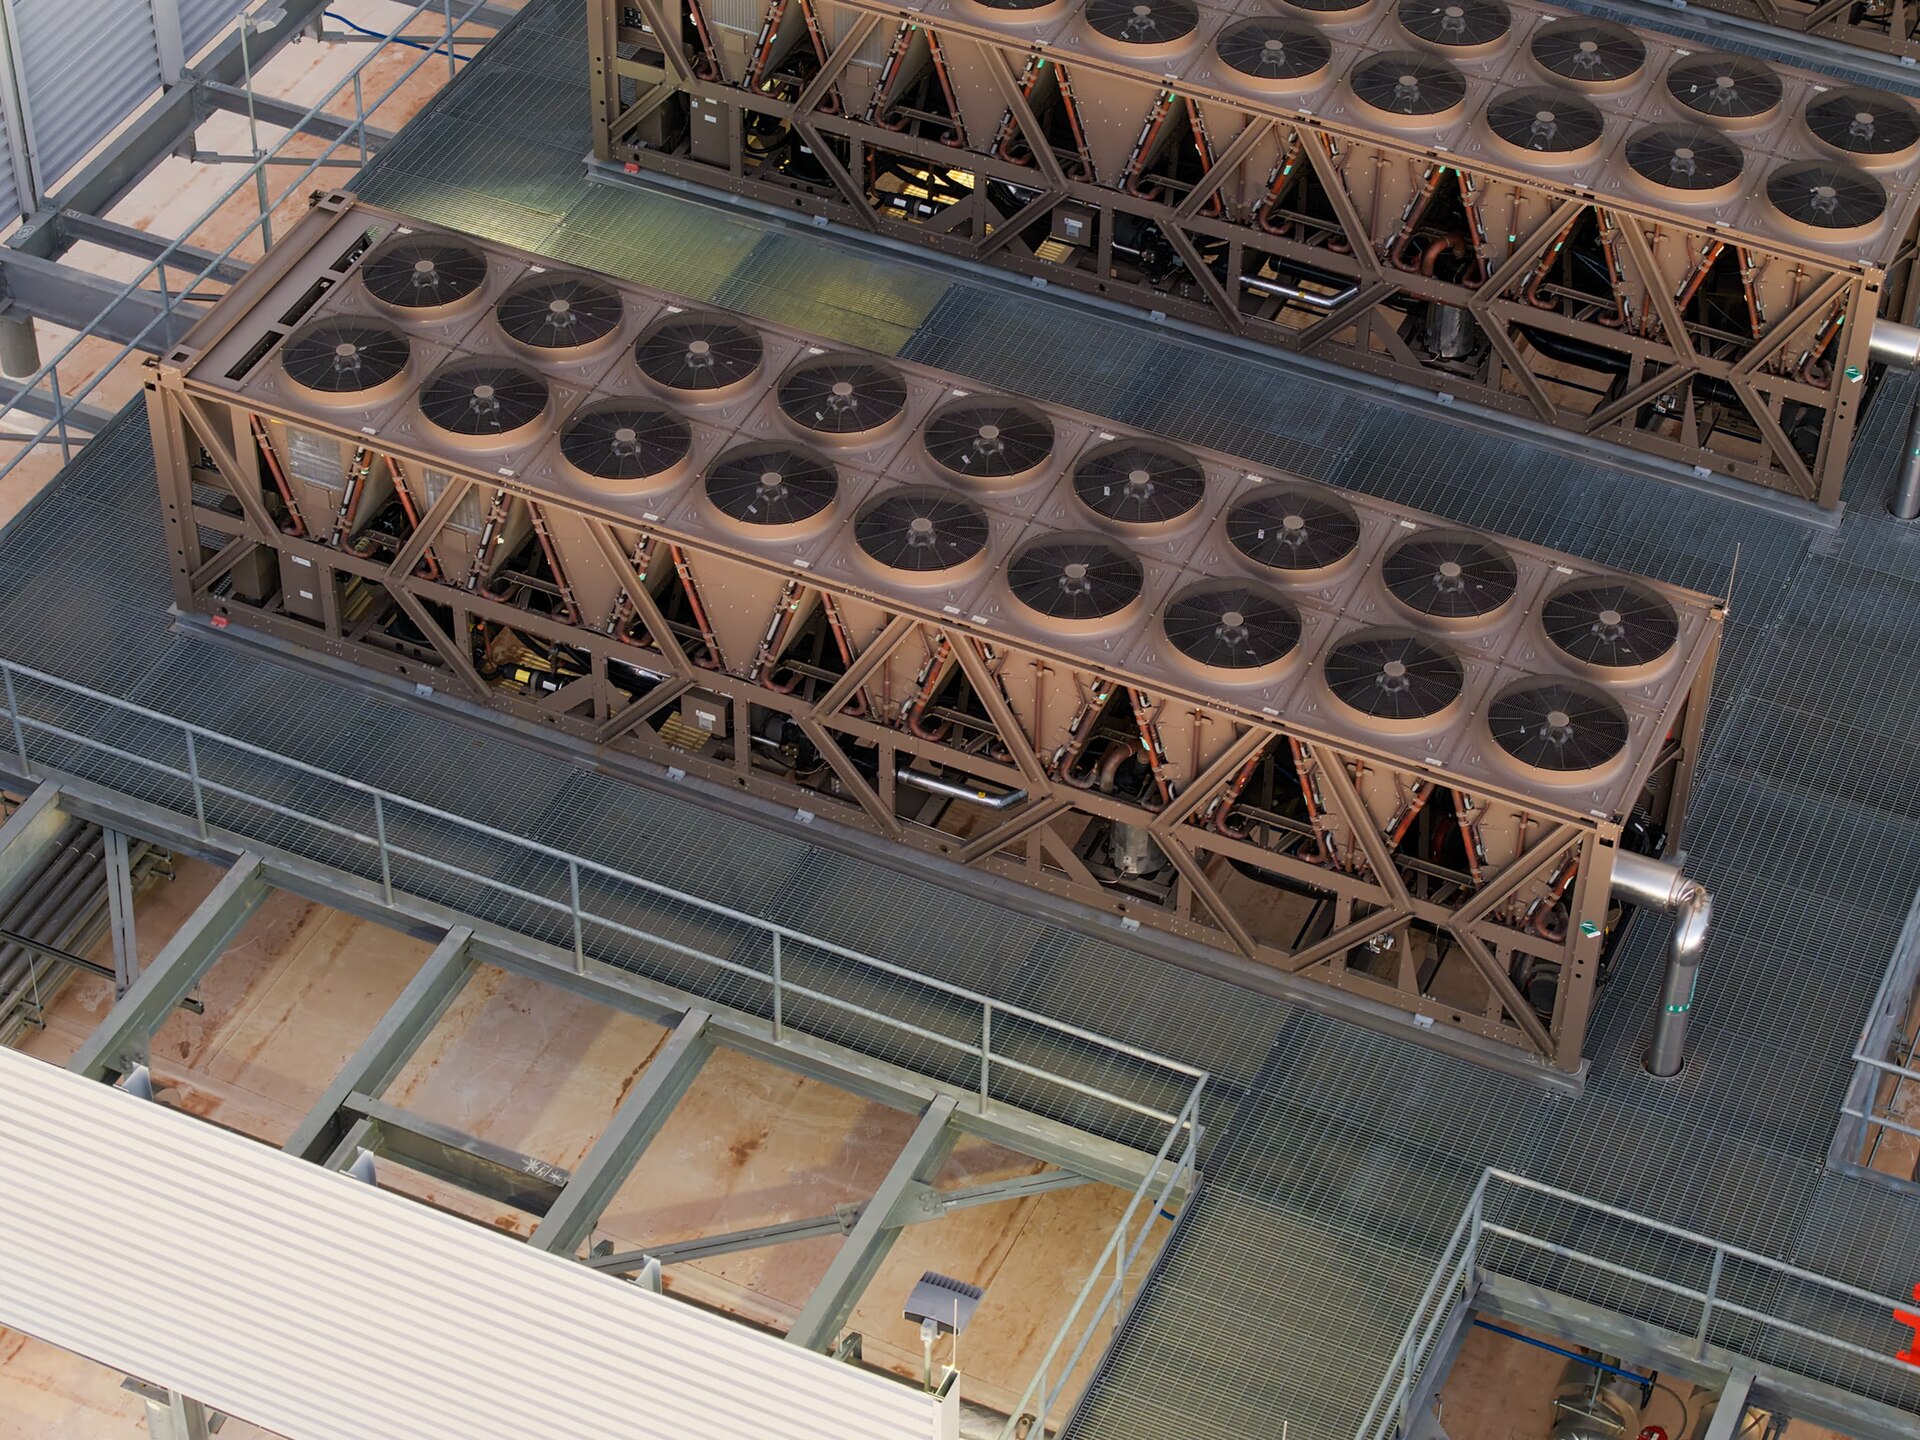
美国亚利桑那州Mesa一处数据中心的屋顶冷却塔,摄于2025年;用于说明数据中心设施能耗。
图片:Rsparks3 / Wikimedia Commons / CC0。图片未作内容修改。

摘要
PUE是数据中心总能耗与IT设备能耗之比,反映供配电、制冷等设施开销相对于IT能耗的水平;它不直接衡量AI任务完成效率。如果两座数据中心消耗相同的电力,一座能够完成更多推理任务、产生更多Token,那么它们的“效率”真的一样吗?
正文
过去几年,PUE几乎是数据中心谈能效时绕不开的指标。
PUE是数据中心总能耗与IT设备能耗之比,反映供配电、制冷等设施开销相对于IT能耗的水平;它不直接衡量AI任务完成效率。
但AI数据中心出现了一个新的问题。
如果两座数据中心消耗相同的电力,一座能够完成更多推理任务、产生更多Token,那么它们的“效率”真的一样吗?
最近,国内外AI基础设施企业开始把这个问题摆到更靠前的位置。一个明显的变化是:数据中心的能效管理,正在从单纯计算“用了多少电”,进一步考虑“这些电产生了多少AI计算结果”。
电力是基础投入,而Token产出提供了一个把能源消耗与AI计算结果连接起来的量化指标。
PUE之外,商汤开始把TPW放进核心管理指标
9月15日,商汤大装置临港AIDC获得中国信通院算力电力协同AAAAA认证。
在这套算电协同体系中,商汤在PUE之外引入了TPW(Tokens per Watt),并将其作为核心管控指标之一。
商汤的定义是,TPW用于衡量单位电力成本所产生的Token数量。
这里沿用的是企业披露的管理口径。严格按物理量区分,Token吞吐率(Token/秒)除以功率(瓦)得到Token/焦耳,而Token数量除以电费得到Token/货币单位。功率效率、单位电量产出和单位电费产出不能直接混用;比较时还需固定模型、输出质量、时延与测量边界。
它并没有取消PUE。
目前临港AIDC的管理体系中,TPW与Token总产出、单位算力能耗、峰谷用电比等指标结合起来,用于数据采集、异常识别、策略调整和效果复盘。
这实际上把数据中心能效的计算对象往前推进了一步。
PUE主要看基础设施本身的电力使用效率;TPW则进一步把电力消耗和AI计算结果联系起来。
对于传统数据中心而言,服务器是不是高效,往往可以通过设备功耗、利用率、PUE等指标判断。
但AI集群的价值最终还是要落到模型训练、推理以及Token生成上。
商汤给出的80%,是什么概念?
商汤披露的数据比较值得关注。
按照其9月15日发布的信息,通过算力与能源协同优化,临港AIDC的单位电力成本Token产出提升了80%;同时,平均电费单价较同地区IDC低约10%。
这里最容易产生误读。
“80%”不是说整个数据中心行业的TPW提高了80%,也不是说换一套软件就可以让所有AI数据中心多产出80%的Token。
这是商汤披露的临港AIDC项目运营结果,并非行业基准提升幅度。
它真正值得关注的地方,是数据中心的优化目标发生了变化。
过去做节能,很多工作围绕制冷系统、供配电、UPS、空调等环节展开,目标通常是降低PUE。
现在AI负载越来越大,单纯减少辅助设施耗电已经不够。
如果能够在相同的电力预算下,通过任务调度、储能、算力调度和电价管理,让更多电力用于有效计算,那么最终应该衡量的,就不只是“少用了多少电”,还包括“同样的电产生了多少有效计算”。
这也是商汤把TPW放进管理体系的逻辑。
NVIDIA也在用另一套语言讲同一个问题
这个变化并不只发生在中国。
9月15日,NVIDIA在AI Infra Summit上进一步讨论了AI Factory的效率问题,其中一个核心方向就是在固定功率预算下,提高Token吞吐和每瓦性能。
NVIDIA则用“每兆瓦Token产出”来描述AI Factory的效率问题。
其中一个已经披露实际测试结果的案例来自Lambda。
Lambda使用NVIDIA HGX B200 GPU服务器进行了五机架、19节点的测试。
在约129kW的功率预算下,16节点基线的Token吞吐量约为404万Token/秒;采用85%的DSX MaxLPS功率策略后,19节点的吞吐量达到约500万Token/秒。
NVIDIA披露的结果是:
节点数量增加19%,集群Token吞吐量增加约24%,性能/瓦提升约23%。
这和商汤的80%不是同一种口径,因此不能放在一起比较。
商汤讲的是单位电力成本Token产出的提升;Lambda案例讲的是固定功率预算下的集群Token吞吐和性能/瓦变化。
但两个案例指向了相似的问题:AI数据中心的效率,正在越来越多地和“有效AI计算产出”联系起来。
NVIDIA还给出了更大的系统级目标:在适合的Vera Rubin NVL72部署环境中,DSX MaxLPS可在相同兆瓦级功率预算下支持更多GPU。
不过,这属于NVIDIA的技术能力披露和特定部署条件下的结果,不能直接当成所有AI数据中心都能获得的普遍增益。
不同厂商正在讨论同一个效率问题
华为9月15日和17日先后发布源网荷储AIDC相关方案,同样提出“每一瓦特产出更多Token”,并把供电、储能、液冷、算力调度和电网互动放在同一套AIDC架构中考虑。
商汤、NVIDIA和华为采用的技术路径并不相同,但讨论正在逐渐靠近同一个问题:
当电力成为AI数据中心的关键约束之后,如何让有限的电力产生更多有效计算?
这也是为什么AI数据中心的效率问题正在从设备层面向系统层面延伸。
供电、储能、液冷、GPU功率管理、任务调度以及电网互动,开始被放到同一个优化框架里考虑。
数据中心运营商需要回答的问题,也随之发生变化。
以前更像是:
这个数据中心每消耗1度电,需要多少电力支撑基础设施?
现在还需要继续追问:
这些电最终产生了多少有效计算?
PUE不会消失,但AI正在增加一层效率指标
这并不意味着PUE失去价值。
PUE仍然是数据中心基础设施能效管理的重要指标。
问题在于,PUE只回答了数据中心基础设施层面的效率问题,并不能直接告诉运营商:
一度电产生了多少Token;
一兆瓦电力能够支撑多少有效推理;
GPU到底有多少时间在进行有效计算;
不同模型、不同推理负载下,电力投入和计算产出之间是什么关系。
因此,AI数据中心的效率体系可能需要多个指标共同描述。
PUE负责看基础设施效率。
GPU/算力利用率负责看计算资源利用效率。
TPW则进一步连接电力投入和AI计算产出。
如果再向经营层面延伸,还可以继续计算每Token的能源成本、综合成本以及不同电价时段下的Token产出。
这样一来,数据中心的效率核算,就不再只是“设备能耗账”,而开始向“算力—电力—计算产出账”延伸。
AI数据中心真正要算的,可能是“每一兆瓦能产生多少计算”
过去建设AI数据中心,最重要的问题之一是能拿到多少电。
现在这个问题依然重要。
但当电力容量越来越成为AI基础设施的约束条件之后,另外一个问题会越来越直接:
拿到同样的电力容量,谁能够产生更多有效AI计算?
这会影响数据中心的建设方案,也会影响芯片、服务器、液冷、供配电、储能和软件调度系统的设计。
真正值得跟踪的,不是PUE会不会被TPW替代,而是AI数据中心是否会逐步建立一套从电网、机柜、GPU到Token的完整效率核算体系。
当电力成为AI基础设施越来越明确的约束条件后,“一座数据中心用了多少电”已经不再是唯一的问题。
更重要的问题可能变成:同样的一兆瓦电,究竟能产生多少有效AI计算?
资料来源
- 商汤临港AIDC算效算电认证披露。来源日期:2026-09-15。
- NVIDIA Lambda DSX MaxLPS案例。来源日期:动态案例页,原始发布日期未明确。
原文:智算通鉴微信公众号。